AI-modell ska ge gruvfordon bättre omvärldsförståelse
En ny AI-modell ska förena bildtolkning, språkförståelse och styrning av autonoma gruvfordon. MineVLA pekar mot maskiner som kan hantera instruktioner och förändringar i omgivningen mer flexibelt. Än så länge handlar det om forskning, inte om ett system som är färdigt för drift i en gruva.
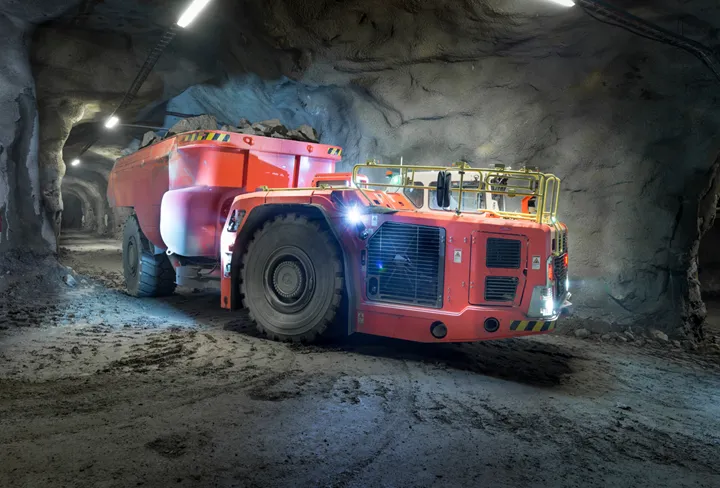
MineVLA tillhör en kategori som kallas vision-language-action-modeller, förkortat VLA. Sådana modeller kombinerar visuell information med språkliga instruktioner och använder underlaget för att välja en handling.
Forskarna Ruixi Qiao och Jie Cheng med fler har anpassat principen till autonoma transporter i gruvmiljö. Målet är att minska avståndet mellan vad ett fordon kan registrera med sina sensorer, hur situationen tolkas och vilket beslut styrsystemet fattar.
Ska kunna hantera fler situationer
Automatiserade transportfordon används redan i gruvindustrin. Driften bygger vanligen på avgränsade arbetsområden, kartlagda färdvägar och detaljerade regler för hur fordonet ska agera. Det ger en förutsägbar och kontrollerbar verksamhet, men systemet kan få svårt att hantera situationer som inte har definierats på förhand.
En VLA-modell skulle på sikt kunna göra det lättare att ge ett fordon nya instruktioner och låta det väga samman dessa med information från omgivningen. Det betyder inte att AI-modellen självständigt kan ersätta gruvans säkerhetssystem eller en mänsklig operatör. Styrningen måste fortfarande omges av regler för bland annat hastighet, trafikseparering, nödstopp och säkra driftlägen.
Lång väg till gruvdrift
Studien presenterar MineVLA som en forskningsmodell. Den visar inte att tekniken är kommersiellt tillgänglig, säkerhetsgodkänd eller införd i en producerande gruva.
Innan denna typ av AI kan användas industriellt behöver den valideras mot verkliga förhållanden, exempelvis damm, varierande ljus, skymda hinder och samtidig trafik med andra fordon och människor. Särskilt viktigt blir att visa hur systemet hanterar ovanliga men säkerhetskritiska situationer – och vad fordonet gör när modellen är osäker eller får motstridig information.
MineVLA är därför främst ett exempel på hur utvecklingen av autonoma gruvfordon kan förflyttas från förprogrammerad körning mot mer situationsanpassad maskinstyrning. Hur långt tekniken har till praktisk användning går ännu inte att fastställa.
Referens: Ruixi Qiao, Jie Cheng, Chenglong Ye, Yunfeng Ai och Yisheng Lv, ”MineVLA: Vision-Language-Action Model for Autonomous Mining”, IEEE/ASME Transactions on Mechatronics, 2026.